相談する

テクノロジー

土台の技術から見る Seekprotocol

プラットフォームは3つのことで成り立っています。誰かがある場所にいたことを、確実に把握する。デジタルのオブジェクトを、実在の地点に置く。そしてAIを、アプリと地図で使い、次は私たちが納品するデータでも使う。

滞在サーバーがチェック
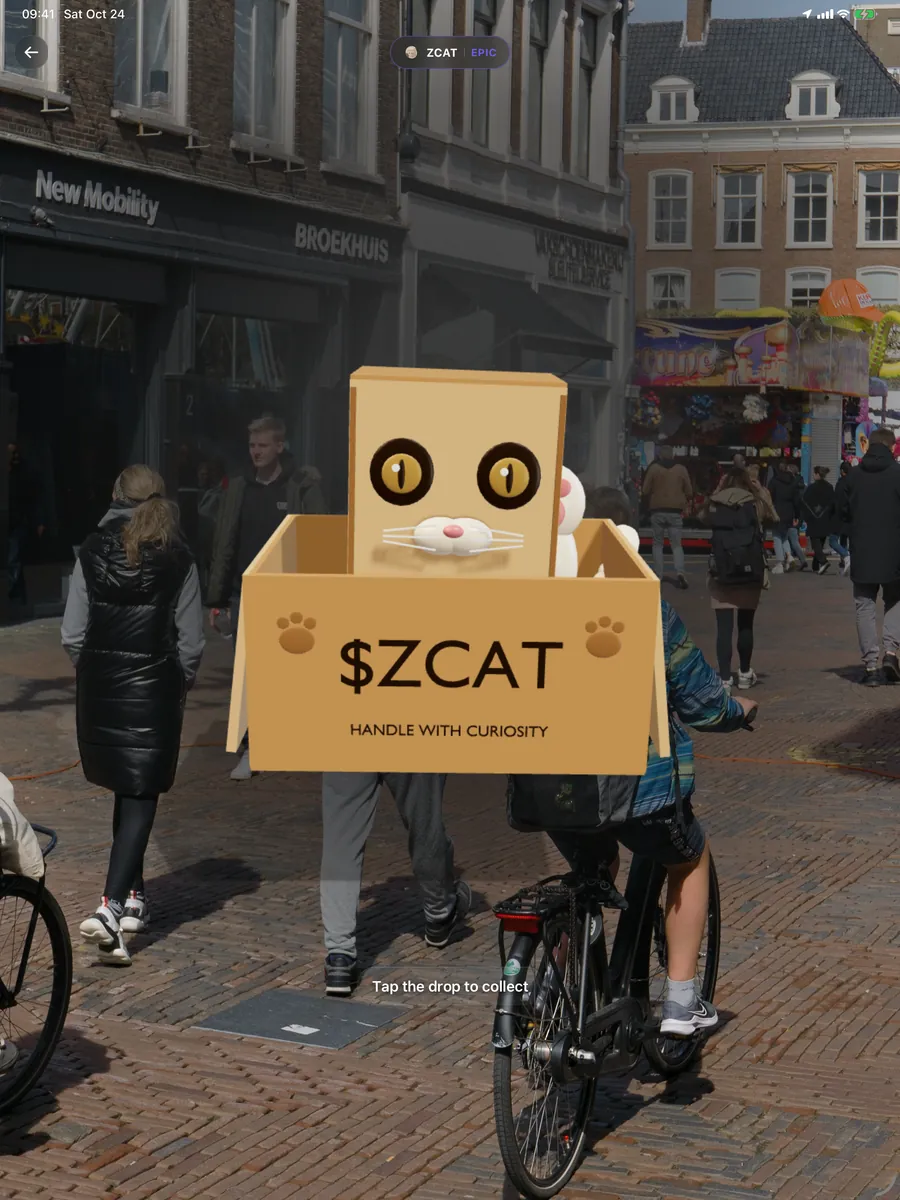
商店街に立つペンギンのキャラクター。アプリのカメラ越しに見たところ
空間ARアプリからのキャプチャ
AIビジョンオブジェクトを認識

滞在証明

本番稼働中

誰かがそこにいたことを、確実に把握する

すべての受け取りは、私たちのサーバーがチェックします。スマホはデータを提供します。決めるのはサーバーです。

  1. 01

    デバイスは本物

    スマホは、改変されていないアプリが本物のデバイスで動いていることを、OSによるアテステーションで証明します。

  2. 02

    位置は偽装されていない

    シミュレートされた位置情報とエミュレーターは拒否され、ログに記録されます。

  3. 03

    距離が正しい

    サーバーがその地点までの距離を自ら測定します。40メートル以内なら有効です。

  4. 04

    速度が人間のもの

    数秒で1キロメートルを移動する人は、歩いていません。

  5. 05

    払い出し時にもう一度

    価値のあるものが払い出されるその瞬間に、同じチェックがもう一度実行されます。

半径

40メートル、測るのはサーバー

報酬は、その地点から40メートル以内で受け取れます。サーバーはGPSの誤差として15メートルを加え、それより外はすべて拒否します。

40 m
キャッチ半径
15 m
GPS誤差の余裕
5 s
2回の試行の間隔
2
報酬ごとの試行回数
  • キャッチ半径 40 m
  • GPS誤差の余裕 15 m
  • 受理
  • 拒否

不正な受け取りはどうなるか

01

拒否され、ログに残る

偽装した位置情報やエミュレーターでは報酬は得られず、その試行は記録されます。

02

試行回数に制限

報酬ごとに試せる回数は少なく、試行の間には待ち時間があります。

03

繰り返す者はブロック

試み続けるアカウントとアドレスは締め出されます。

空間コンピューティング

本番稼働中

デジタルのオブジェクトを、実在の地点に

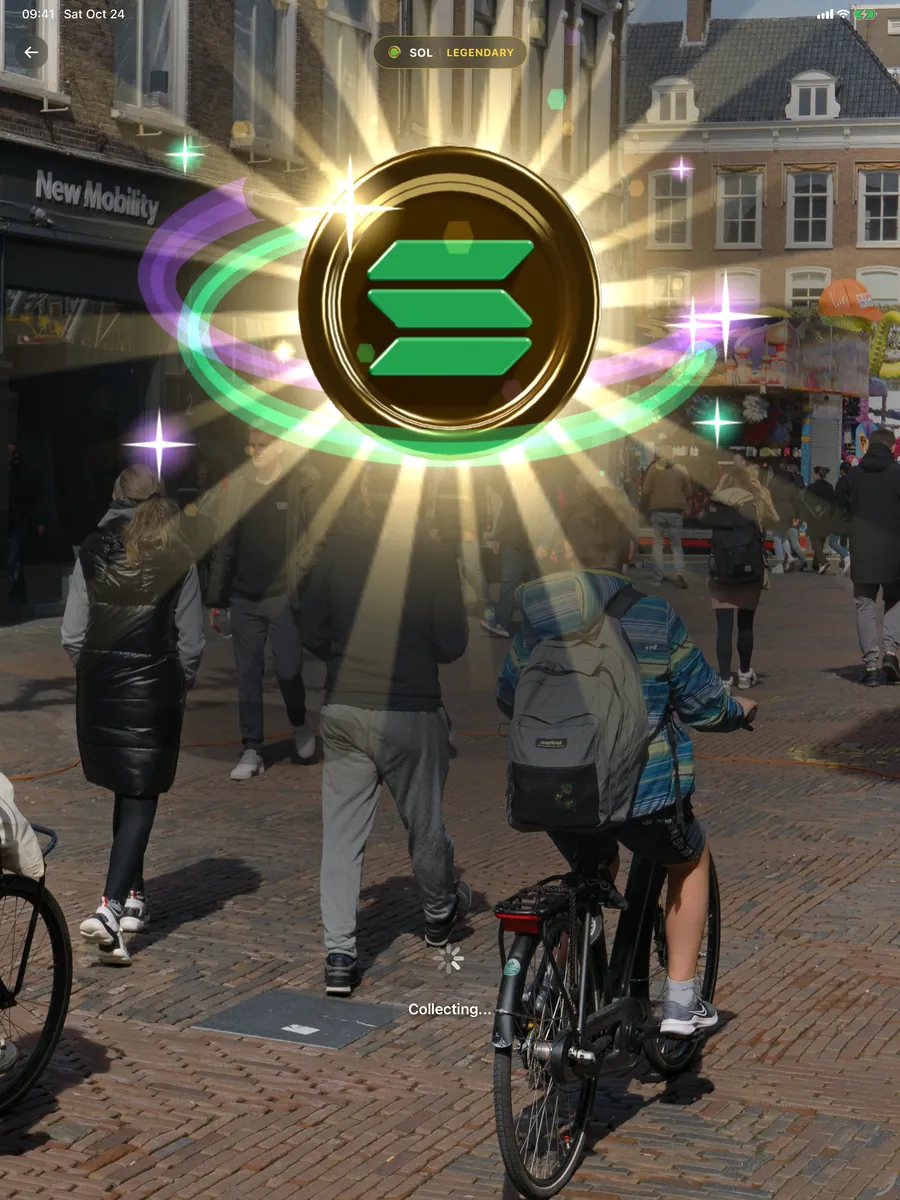
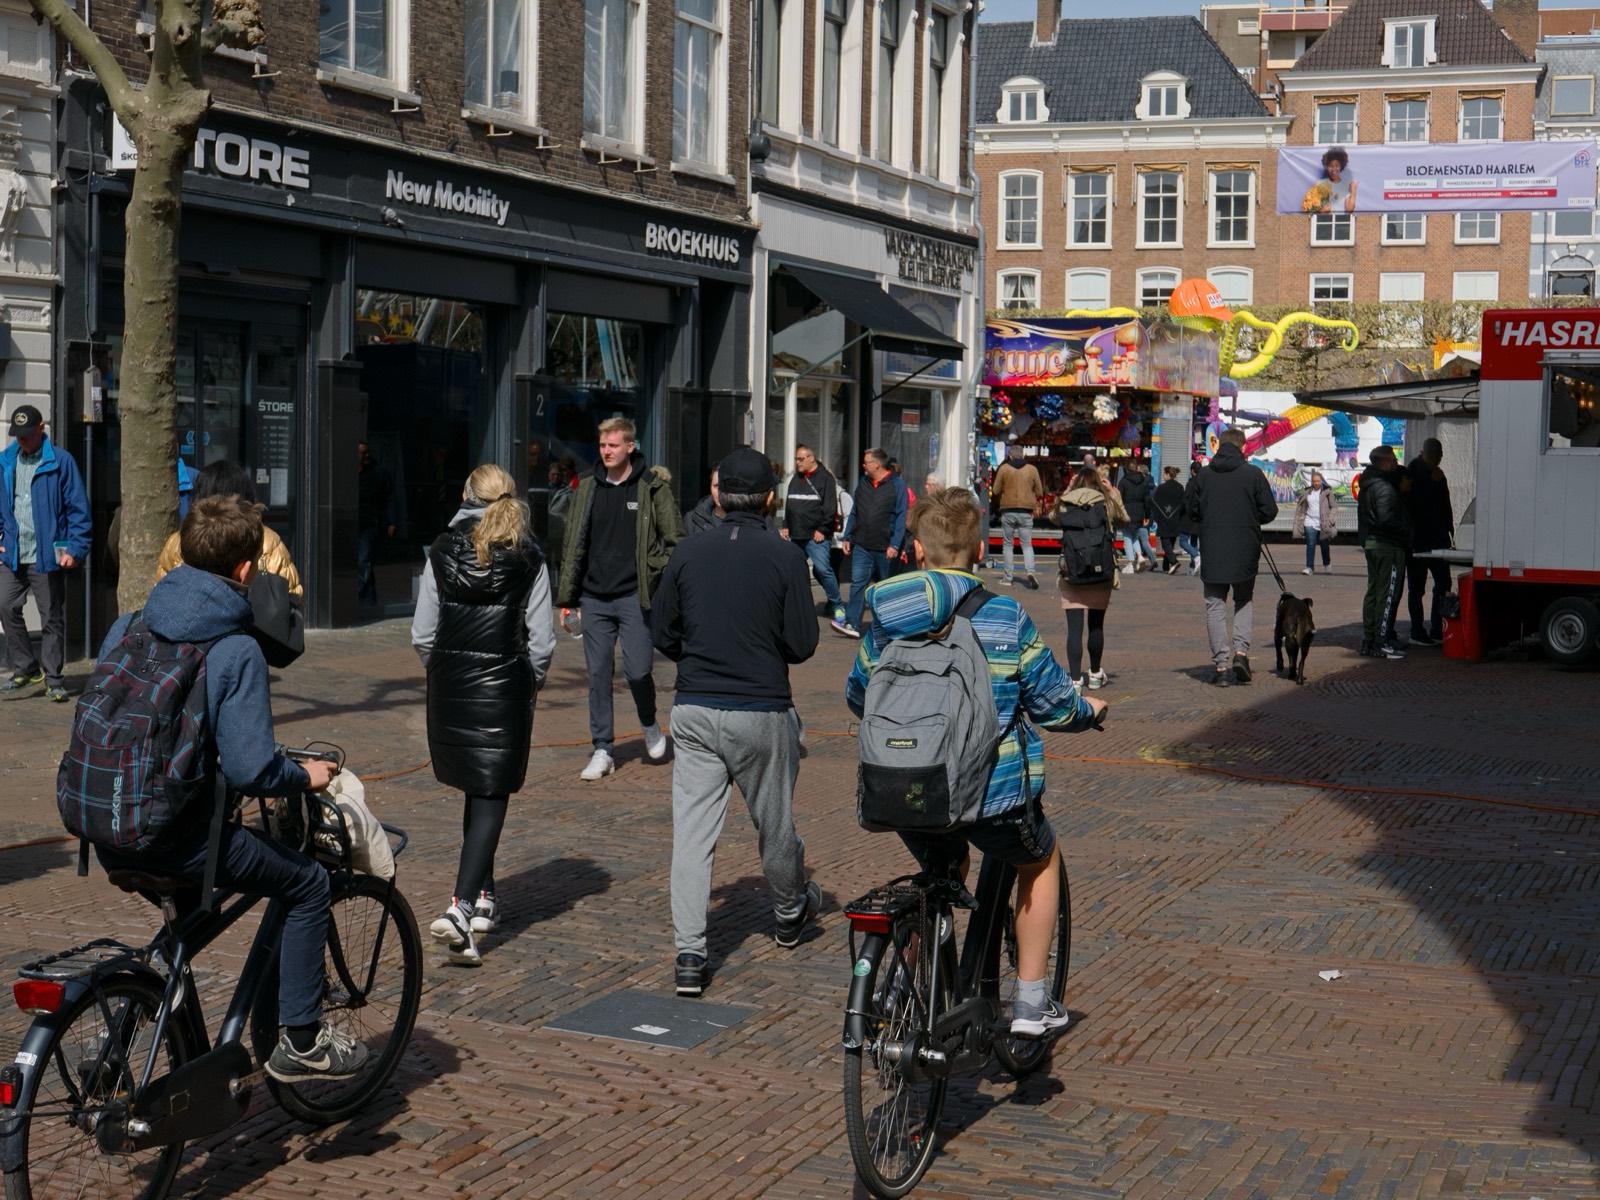
カメラの中では、3Dオブジェクトが通りに立っています。場所は、私たちのサーバーが配置したその地点です。ヘッドセットも追加のハードウェアも要らず、普通のスマホやタブレットで動きます。
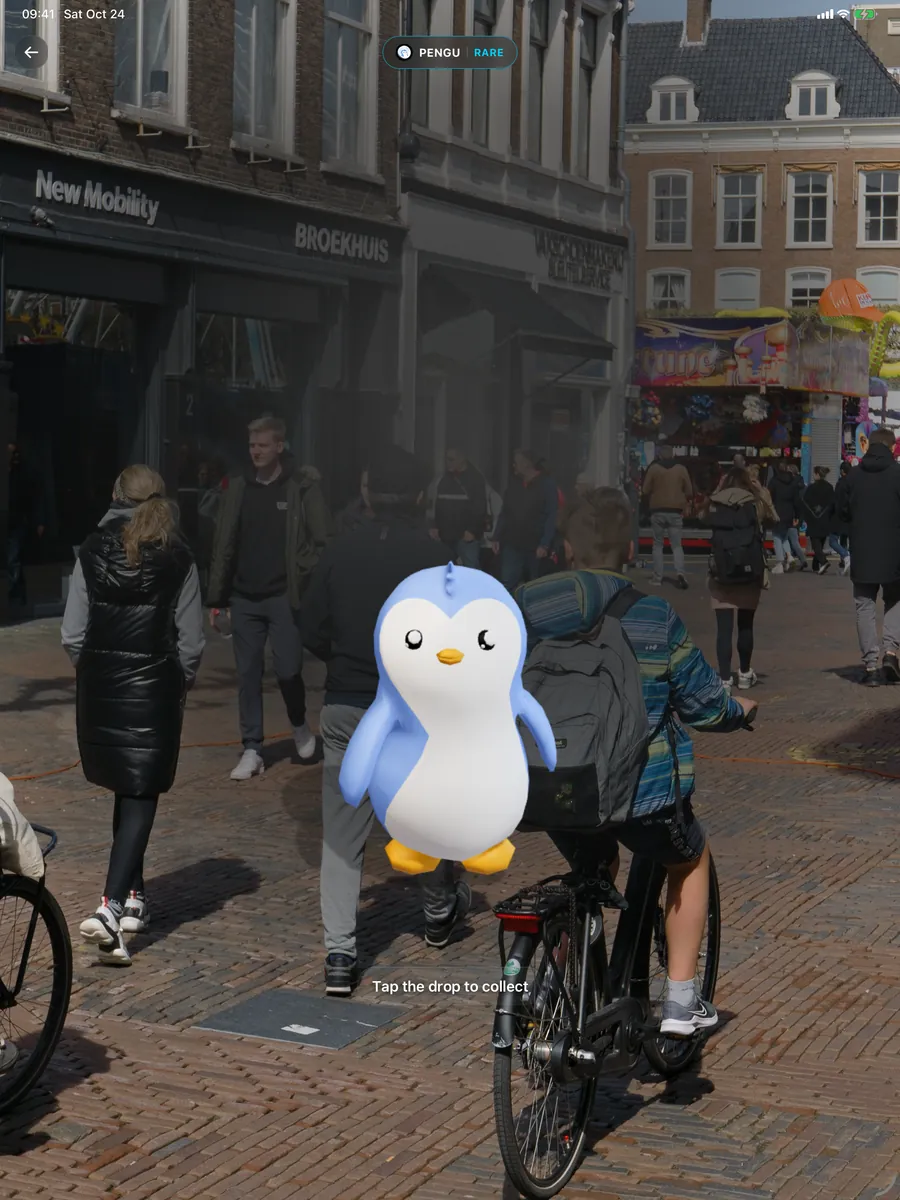
商店街に立つペンギンのキャラクター。アプリのカメラ越しに見たところ
同じ通りにある、段ボール箱に入った猫。アプリのカメラ越しに見たところ
同じ通りにあるSolanaの報酬。アプリのカメラ越しに見たところ
アプリからのキャプチャ。ハールレムの通りにて。

サーバーから通りまで

  1. 配置サーバーが歩道上の地点を選びます。
  2. 地図に表示近くのプレイヤーに、現れるのが見えます。
  3. 歩いて向かうアプリが残りの距離をカウントダウンします。
  4. カメラが開くオブジェクトが通りに立っています。
  5. 受け取り完了サーバーのチェックを経て。
01

カメラ内のワールドトラッキング

スマホが周囲をフレームごとに追跡するので、まわりを歩いてもオブジェクトはその場にとどまります。

02

サーバーが配置

何がどこに現れるかはサーバーが決めます。歩道にだけ置き、高速道路や水の中には決して置きません。

03

パートナーごとの3Dコンテンツ

どのコインにも専用の3Dキャラクターがあります。パートナーがポータルから提供すると、アプリの更新なしで公開されます。

AI

アプリ、地図、データの中のAI

私たちはAIを4つの場所で使っています。それぞれに、どこまで進んでいるかを示しています。
Seekprotocolアプリのアシスタント、Mobi。2つの目がある色付きの球体

Mobi

話しかけられるアシスタント

Mobiはアプリ内の音声アシスタントです。声で答え、プレイヤーに代わってアプリを操作できます。

  • 近くの報酬を探す
  • 報酬を地図にマークする
  • ウォレットの残高を調べる
  • 地図を移動、ズームする
例

いちばん近い報酬はどこ?

120メートル先の角にひとつあります。地図にマークしておきました。

本番稼働中

音声アシスタントのMobi

プレイヤーはMobiに話しかけます。アシスタントは近くの報酬を探してマークし、残高を調べ、地図を操作できます。

開発中

3D地図のためのビジョンモデル

視覚言語モデルがストリート写真を読み取り、建物の正面のどこに窓やディテールが来るかを割り出します。初期段階の取り組みで、最初の建物が地図に載っています。

招待制

コンテンツチェック

サードパーティ製クエストのテキストと画像は、人が審査する前に自動のコンテンツチェックを通ります。

開発中

ビジョンモデル向けの学習データ

場所と時刻が検証され、ラベルが付き、顔が除去された撮影データ。通り、店舗、建物を認識する必要があるモデルの学習を想定しています。

技術についてご質問は?

つくった本人たちに聞いてください

あなたのチームに、アーキテクチャを喜んでご説明します。